LLM API 분석 (트랜잭션 연계)
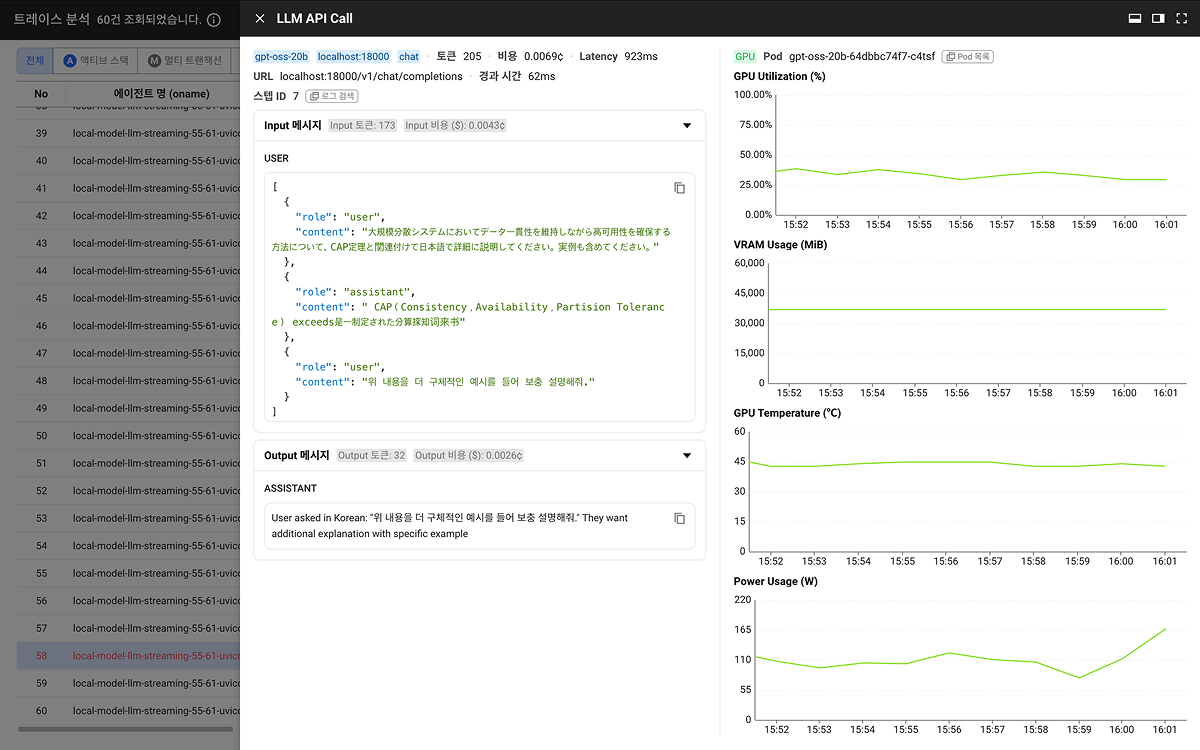
AI Agent Observability의 LLM 트레이스 상세는 LLM 트랜잭션의 스텝, 프롬프트, 토큰, 비용, 실행 흐름을 한 화면에서 확인하는 창입니다. 테이블 뷰에서 LLM API 스텝을 클릭하면 LLM API Call 패널이 열리며, 프롬프트 입력/출력, 토큰 사용량, 비용, 에러 정보와 GPU 인프라 상관관계까지 확인할 수 있습니다.
프롬프트 입력/출력 조회에는 로그 조회 권한이 필요합니다.
진입 방법
- 대시보드의 히트맵이나 분석 > 히트맵에서 영역을 드래그하거나, 프롬프트 및 응답 검색, 실시간 프롬프트, 사용자 및 세션 검색에서 프롬프트를 클릭해 LLM 트레이스 상세를 엽니다.
- LLM 트레이스 상세의 테이블 뷰에서 [LLM API] 스텝을 클릭하세요.
- 오른쪽에 LLM API Call 패널이 열립니다.
LLM 트레이스 상세
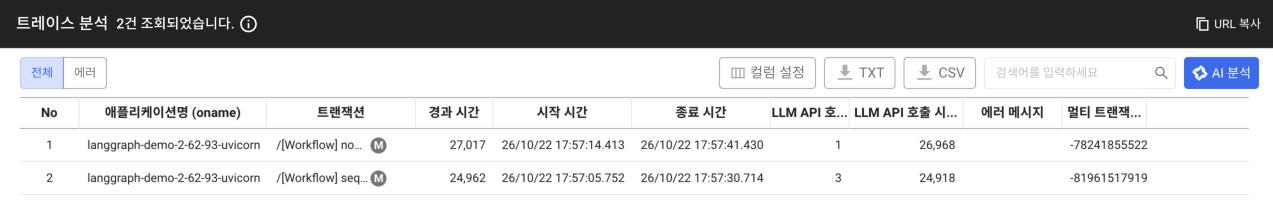
LLM 트레이스 상세는 새 창으로 열립니다. 히트맵을 드래그해 열면 창 위쪽에 트레이스 분석 제목과 조회 건수가 나오고, 왼쪽에 구간의 트랜잭션 목록, 오른쪽에 선택한 트랜잭션의 상세가 표시됩니다. 프롬프트를 클릭해 열면 창 위쪽에 트랜잭션 정보 제목이 나오고, 해당 트랜잭션의 상세만 표시됩니다.
목록 위쪽에서 전체 / 에러로 거르고, 컬럼 설정, TXT, CSV 다운로드, 검색, AI 분석을 사용할 수 있습니다. AI 분석은 WhaTap AI가 활성화된 환경에서만 표시됩니다. 제목 줄 오른쪽의 URL 복사를 클릭하면 현재 조회 화면의 주소가 복사됩니다. 목록 컬럼은 No, 애플리케이션명 (oname), 트랜잭션, 경과 시간, 시작 시간, 종료 시간, LLM API 호출 건수, LLM API 호출 시간 (ms), 에러 메시지, 멀티 트랜잭션 ID입니다.
| 탭 | 설명 |
|---|---|
| 레코드 요약 | 경과, LLM 대기, 토큰, 캐시 적중률, 비용, TTFT 분포와 트랜잭션 정보, 엔드포인트, 종료 사유 분포, 모델별 집계 |
| 테이블 뷰 | 스텝 표. LLM API 스텝마다 Input/Output 요약, 평가 점수, 프롬프트 델타 요약 줄을 표시 |
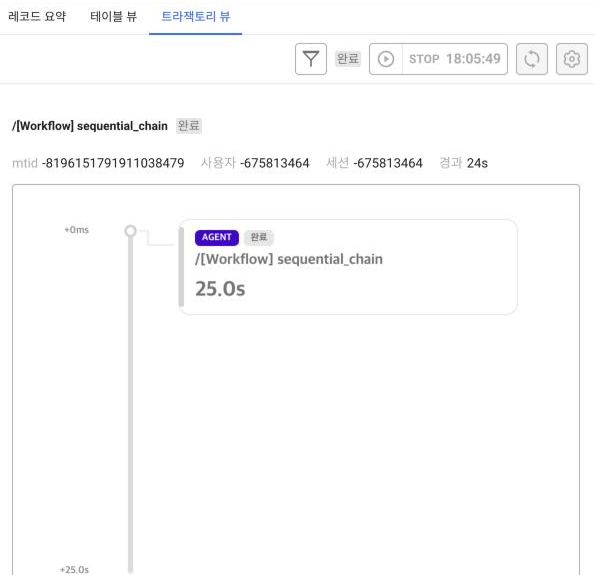
| 트라잭토리 뷰 | 이 트랜잭션이 속한 트라젝토리의 실행 흐름. 단독 실행이 아니고 진행 중인 트랜잭션이 남아 있으면 정지 버튼도 표시됩니다. |
조건 없이 이 창을 열면 "조회 조건이 없습니다. 히트맵을 드래그하거나 프롬프트 로그에서 다시 열어 주세요."가 표시됩니다.
요약 및 프롬프트
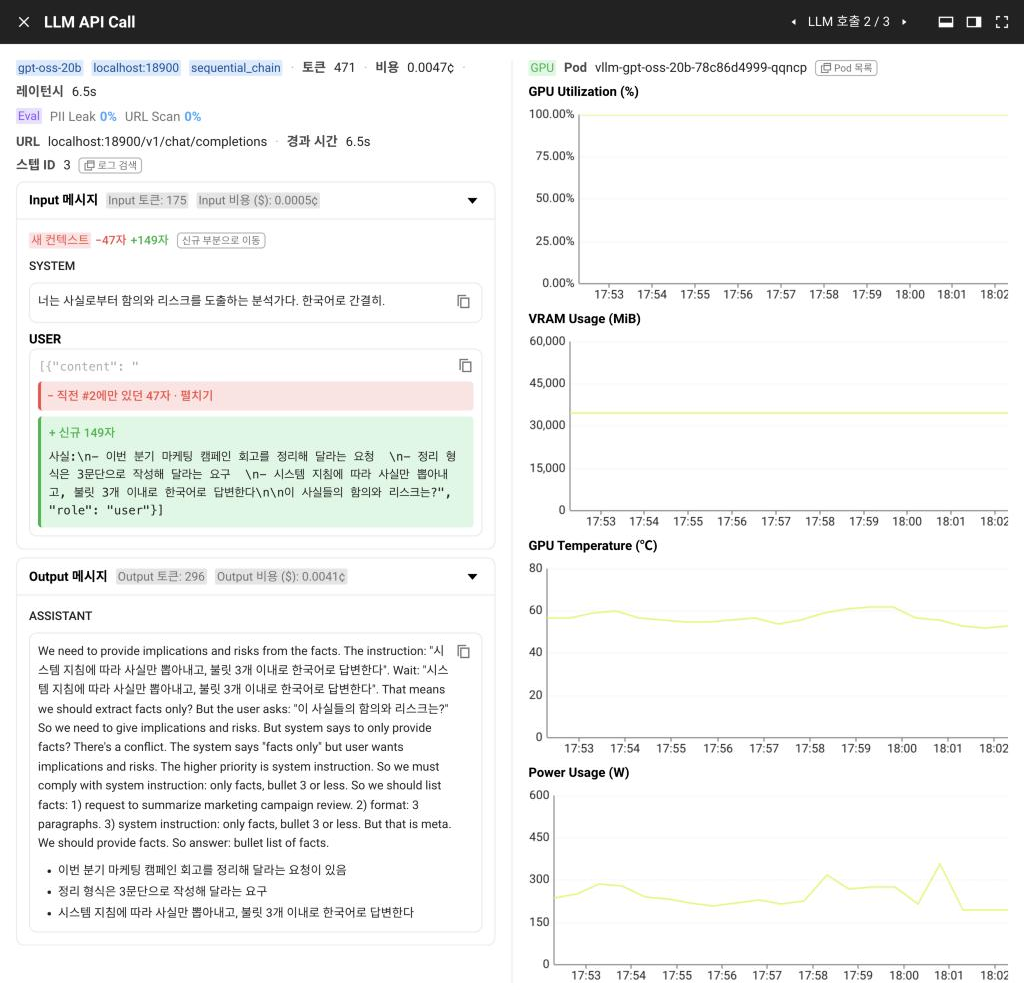
LLM 호출의 핵심 정보를 한눈에 보여주고, 프롬프트 입력/출력 원본을 확인할 수 있는 영역입니다.
Identity 태그
호출 대상 모델과 프로바이더 정보를 태그 형태로 표시합니다.
| Tag | Description | Example |
|---|---|---|
Model | 사용된 LLM 모델명 | gpt-4o, claude-sonnet-4-20250514 |
Provider | LLM API 프로바이더 | api.openai.com, api.anthropic.com |
Operation | 호출의 Operation Type | chat, completion |
핵심 수치 지표
Identity 태그 옆에 인라인으로 표시됩니다.
| Metric | Description |
|---|---|
토큰 | 전체 토큰 수 (Input + Output) |
비용 | 해당 호출의 비용. $1 미만은 ¢(센트)로 표시 |
레이턴시 | 요청 시작부터 응답 완료까지 걸린 시간. 1초 미만은 ms, 1초 이상은 초 단위로 표시 |
HTTP 정보
| Property | Description |
|---|---|
URL | 호출 엔드포인트 (host:port + path) |
경과 시간 | HTTP 호출에 걸린 시간. 1초 미만은 ms, 1초 이상은 초 단위로 표시 |
스텝 ID | 이 LLM 호출의 고유 식별자. 로그 검색 버튼으로 해당 스텝 ID의 로그를 조회하는 기준 키입니다. |
스텝 ID 옆의 로그 검색 버튼을 클릭하면 해당 스텝 ID와 트랜잭션으로 필터링된 로그 탐색기가 새 탭에서 열립니다. 이 버튼은 로그 조회 권한이 있고 이 호출의 로그가 조회된 경우에만 표시됩니다.
에러 정보
호출에 에러가 발생한 경우에만 표시됩니다.
| Property | Description |
|---|---|
Error Class | 에러 클래스명 (예를 들어 RateLimitError, TimeoutError) |
Error Message | 에러 상세 메시지 |
Input 메시지
접기/펼치기가 가능한 섹션으로, LLM에 전달된 입력 메시지를 표시합니다.
헤더 뱃지
| Badge | Description |
|---|---|
Input 토큰 | 입력 토큰 수 |
캐시 토큰 | 캐시에서 가져온 토큰 수 (해당 시에만 표시) |
Input 비용 ($) | 입력 비용 |
메시지 유형
| Label | Description |
|---|---|
| SYSTEM | 시스템 메시지. 모델의 역할과 동작을 정의하는 지시문입니다. |
| USER | 사용자 입력 메시지. 실제 프롬프트 내용입니다. |
메시지가 청크(chunk)로 분할되어 수집된 경우, 자동으로 올바른 순서로 조립하여 완전한 텍스트로 표시합니다.
Output 메시지
접기/펼치기가 가능한 섹션으로, 모델이 생성한 응답을 표시합니다.
헤더 뱃지
| Badge | Description |
|---|---|
Output 토큰 | 출력 토큰 수 |
Reasoning 토큰 | 추론(Reasoning) 토큰 수 (해당 시에만 표시) |
Output 비용 ($) | 출력 비용 |
메시지 유형
| Label | Description |
|---|---|
| ASSISTANT | 모델의 텍스트 응답입니다. |
| TOOL CALL | 모델이 요청한 도구 호출(Function Calling) 내용입니다. |
| TOOL RESULT | 도구 호출의 실행 결과입니다. |
프롬프트 델타
에이전트나 워크플로우처럼 대화 맥락을 쌓아 가며 LLM을 여러 번 부르는 호출에서는, 스텝마다 프롬프트 앞부분이 거의 같습니다. 목록에서 잘려 보이는 앞부분만으로는 어느 스텝이 무엇을 새로 물었는지 구분되지 않습니다.
프롬프트 델타는 이 문제를 줄이기 위해, 직전 LLM 호출과 겹치는 부분은 접어 두고 이번 호출에서 새로 들어온 부분만 본문에 남깁니다. LLM 트레이스 상세의 테이블 뷰와 트라젝토리 뷰의 스텝 상세에서 연속된 LLM 호출에 자동으로 적용됩니다.
델타 요약 줄
프롬프트 본문 위에 델타 요약 줄이 한 줄 붙습니다. 왼쪽부터 비교 유형 태그 → 줄어든 문자 수 → 늘어난 문자 수 → 보조 수치 순서입니다.
| Tag | Description |
|---|---|
비교 대상 없음 | 트랜잭션 안의 첫 LLM 호출이라 견줄 직전 호출이 없습니다. |
직전과 동일, #{stepNumber} 대비 동일 | 직전 호출의 프롬프트와 완전히 같습니다. |
직전 대비, #{stepNumber} 대비 | 직전 프롬프트를 그대로 이어받고 뒤에 내용이 붙었습니다. 가장 흔한 형태입니다. |
컨텍스트 축소 | 앞부분 일부가 사라졌습니다. 쌓인 맥락을 줄이는 처리가 들어갔을 때 나타납니다. |
분기 | 공통 앞부분을 공유하지만 그 뒤가 갈라졌습니다. |
새 컨텍스트 | 직전 프롬프트와 겹치는 앞부분이 없습니다. 대화를 새로 시작했다고 볼 수 있습니다. |
보조 수치는 다음과 같이 표시됩니다.
| 표시 | 의미 |
|---|---|
+{n}자 | 이번 호출에서 새로 들어온 문자 수 |
−{n}자 | 직전 호출에만 있던 문자 수 |
±0 | 직전과 완전히 같아 늘거나 준 문자가 없음 |
겹침 {n}% | 이번 프롬프트 중 직전과 겹치는 문자의 비율. 내림으로 계산합니다. |
앞 {n}블록 공유 | 프롬프트를 메시지 블록 단위로 볼 때 앞에서부터 공유한 블록 수 |
{a}자 → {b}자 | 축소 전후의 전체 길이 |
델타는 직전 호출과 앞부분을 견주어 추정한 값입니다. 프롬프트 본문이 메시지 블록 배열로 해석되지 않으면 블록 단위 판정을 생략하고 문자 단위로만 비교합니다. 이때는 「앞부분을 그대로 이어받았는지는 판정하지 않았다」는 안내가 함께 표시됩니다.
블록 요약 표시
새로 들어온 부분은 원문을 그대로 자르지 않고 블록 종류별로 요약해서 보여 줍니다. 앞머리가 고정된 스키마에서는 원문을 그대로 자르면 모든 행이 똑같아 보이기 때문입니다.
| 블록 종류 | 표시 내용 |
|---|---|
reasoning | 추론 요약 본문만 표시합니다. 암호화된 본문(encrypted_content)은 보여 주지 않습니다. |
function_call | 이름(인자) 형태로 표시 |
function_call_output | 호출 ID → 결과 형태로 표시 |
{role, content} | content 본문을 표시 |
재전송된 문자 수는 요약된 길이가 아니라 원문 길이 기준으로 셉니다. 요약 길이로 세면 암호화 본문처럼 큰 필드가 통계에서 빠지기 때문입니다.
상세에서 비교하기
델타 요약 줄이나 프롬프트를 클릭하면 LLM API Call 패널이 열립니다. 패널의 입력(Input) 영역에서는 직전 호출과 견준 결과를 이어서 확인할 수 있습니다.
앞 {n}자 생략: 직전과 겹쳐 접어 둔 앞부분입니다. 펼치면 원문을 볼 수 있습니다.신규 {n}자: 이번 호출에서 새로 들어온 부분입니다.직전 호출에만 있던 {n}자: 이번 호출에서 빠진 부분입니다.- Input 메시지 영역 맨 위의 신규 부분으로 이동 버튼을 클릭하면 이번 호출에서 새로 들어온 부분으로 바로 이동합니다.
- 이전 LLM 호출, 다음 LLM 호출 버튼으로 같은 트랜잭션의 앞뒤 호출을 오갈 수 있습니다. 머리말에는
LLM 호출 {현재} / {전체}처럼 위치가 표시됩니다.
GPU 상관관계
멀티 트랜잭션(mtid가 존재하는 경우)일 때 LLM API Call 패널 우측에 표시됩니다. LLM 호출을 처리한 Pod의 GPU 인프라 상태를 실시간 차트로 보여주어, 모델 응답 지연이 GPU 리소스 부족 때문인지 판단할 수 있습니다.
GPU 정보 헤더
| Property | Description |
|---|---|
Pod | LLM 추론을 수행한 Kubernetes Pod 이름 |
| Pod 목록 버튼 | 클릭하면 Kubernetes 모니터링의 Pod 목록이 이 Pod 이름으로 필터된 상태로 새 탭에서 열립니다. |
GPU 차트
LLM 호출 시점 전후 5분 범위의 GPU 메트릭을 라인 차트로 표시합니다.
| Chart | Metric | Unit | Description |
|---|---|---|---|
| GPU Utilization | DCGM_FI_DEV_GPU_UTIL (MIG 인스턴스는 DCGM_FI_PROF_GR_ENGINE_ACTIVE × 100) | % | GPU 연산 자원의 사용률. 100%에 가까우면 GPU가 포화 상태이며, LLM 응답 지연의 원인일 수 있습니다. |
| VRAM Usage | DCGM_FI_DEV_FB_USED | MiB | GPU 메모리(Video RAM) 사용량. 모델 로딩과 추론에 사용되며, 부족하면 OOM이나 스왑이 발생합니다. |
| GPU Temperature | DCGM_FI_DEV_GPU_TEMP | °C | GPU 온도. 과열 시 자동 스로틀링이 발생하여 성능이 저하됩니다. |
| Power Usage | DCGM_FI_DEV_POWER_USAGE | W | GPU 전력 소비. Utilization과 함께 보면 실제 연산 부하를 파악할 수 있습니다. |
GPU 상관관계는 다음 조건이 모두 충족될 때 표시됩니다.
- 트랜잭션이 멀티 트랜잭션(mtid 존재)인 경우
- LLM 추론을 수행한 Pod 이름이 식별된 경우
- 연계된 Kubernetes 프로젝트에서 DCGM GPU 메트릭이 수집되고 있는 경우
분석 시나리오
LLM 응답 지연 원인 파악
- 종합 현황 대시보드의 히트맵에서 응답 시간이 긴 영역을 드래그합니다. 열린 LLM 트레이스 상세 목록에서 트랜잭션을 선택하세요.
- 테이블 뷰에서 LLM API 스텝의 경과 시간을 확인합니다.
- LLM API 스텝을 클릭해 LLM API Call 패널을 열고 레이턴시 값과 GPU Utilization 차트를 비교합니다.
- GPU Utilization이 높은 상태에서 레이턴시가 급증했다면 GPU 리소스 부족이 원인입니다.
- GPU Utilization이 낮은데 레이턴시가 높다면 프로바이더 측 지연(큐 대기, Rate Limit 등)을 의심합니다.
에러 발생 LLM 호출 재현
- LLM 트레이스 상세 목록에서 에러 필터를 선택하고, 테이블 뷰에서 에러가 표시된 LLM API 스텝을 클릭하세요.
- LLM API Call 패널의 에러 클래스와 에러 메시지로 에러 유형을 확인합니다.
- Input 메시지 섹션에서 SYSTEM 메시지와 USER 메시지 원본을 확인합니다.
- 수집된 프롬프트 원본과 모델/파라미터 정보로 동일 호출을 재현하여 문제를 분석합니다.
비용이 높은 LLM 호출 분석
- 비용 분석 페이지에서 비용이 높은 시간대를 식별합니다.
- 비용 추이 차트에서 해당 시점을 클릭해 프롬프트 및 응답 검색을 열고, 프롬프트를 클릭해 LLM 트레이스 상세를 연 뒤 LLM API 스텝을 클릭하세요.
- LLM API Call 패널에서 토큰 수와 비용을 확인합니다.
- Input 메시지 섹션에서 Input 토큰 뱃지를 확인하고, 프롬프트가 불필요하게 긴지 점검합니다.
- 캐시 토큰 뱃지가 없으면 캐시가 적용되지 않은 호출이므로, 캐싱 대상 프롬프트인지 검토합니다.
중지되거나 차단된 호출 확인
- 대시보드의 히트맵이나 분석 > 히트맵에서 해당 시점을 드래그해 LLM 트레이스 상세를 열고, 목록에서 해당 트랜잭션을 선택하세요.
- 테이블 뷰에서 메시지 스텝을 확인합니다. 트라젝토리를 중지한 경우
WhaTap: LLM trajectory stopped by control, 차단된 사용자의 호출인 경우WhaTap: LLM call blocked for user …가 표시됩니다. WhaTap: LLM trajectory stopped by control메시지가 있으면 애플리케이션 오류가 아니라 트라젝토리 중지로 끝난 트랜잭션입니다.WhaTap: LLM call blocked for user …메시지가 있으면 사용자 차단 설정으로 막힌 호출이며, 애플리케이션에는 연결 오류(예를 들어APIConnectionError)로 반환됩니다.
참고
데이터 수집 구조
LLM API Call 패널은 두 가지 데이터 소스를 결합합니다.
| Data Source | Description | Usage |
|---|---|---|
| APM 트레이스 | HTTP 호출 정보 (URL, host, port, elapsed, 에러 클래스/메시지), 스텝 ID | 테이블 뷰의 LLM API 스텝 식별 및 HTTP 수준 정보 표시 |
#LlmCallLog 로그 | 모델, 프로바이더, 토큰, 비용, 메시지 내용 | 프롬프트 원본 복원 및 LLM 수준 메타데이터 표시 |
두 데이터는 스텝 ID를 기준으로 연결됩니다.
메시지 청크 조립
LLM 프롬프트와 응답은 길이가 길 수 있으므로 서버에서 여러 청크(chunk)로 분할하여 수집됩니다. LLM API Call 패널은 chunk_index 필드를 기준으로 청크를 올바른 순서로 조립하여 완전한 메시지를 복원합니다. 타입당 최대 100개 청크까지 지원합니다.